
Bu sayfada 8 bölüm
Temel bulgular
- Ghost ads, artışı klasik holdout testleri kadar hassas ölçüyor ve maliyeti en az on kat düşük (Johnson, Lewis ve Nubbemeyer, 2017). [Deney]
- Bir çevrimiçi perakendecinin görüntülü yeniden hedefleme reklamlarının ghost-ad testinde reklamlar site ziyaretlerini %17,2, satın almaları %10,5 artırdı (Johnson ve ark., 2017). [Deney]
- Kesin sonuç veren bir çevrimiçi reklam deneyi 10 milyon kişi-haftadan fazla veri gerektirebilir (Lewis ve Rao, 2015). [Deney]
- Sentetik kontroller yalnızca belli koşullarda güvenilirdir; bunlar arasında iyi bir ön dönem uyumu ve yeterli sayıda karşılaştırma birimi var (Abadie, 2021). [Yöntem derlemesi]
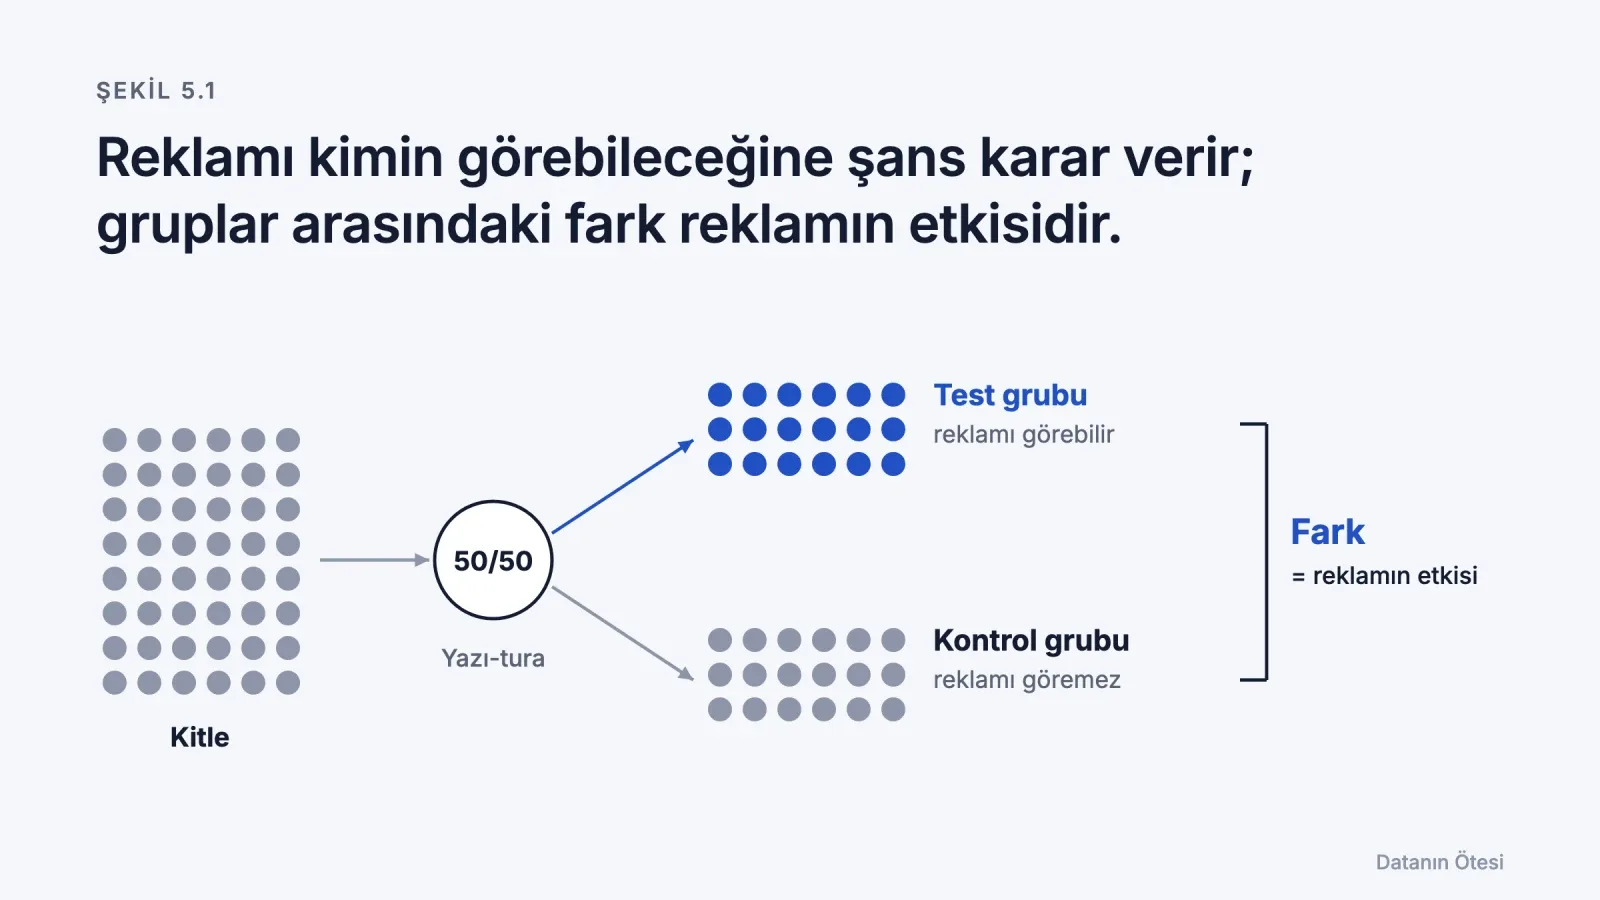
Kısa cevap. Reklamı kimin görebileceğine rastgele karar verin, sonra gruplar arasındaki sonuçları karşılaştırın. Reklamı görmeye yalnızca şans karar verdiği için gruplar reklam dışında her şeyde benzerdir ve aradaki fark reklamın nedensel etkisini tahmin eder. Kullanıcı düzeyinde holdout, ghost ads ve bölgesel deneyler başlıca tasarımlardır. Her birinin bir maliyeti, bir asgari büyüklüğü ve bir kör noktası vardır.
Artımsallık testi nedir?
Artımsallık testi, reklamı kitlenin bir kısmından ya da bazı bölgelerden rastgele esirgeyen ve gruplar arasındaki sonuç farkını ölçen bir deneydir. Bu fark artımsal etkidir: reklamlar sayesinde gerçekleşen satışlar. Artımsal ciroyu harcamaya bölmek artımsal reklam harcaması getirisini (iROAS) verir; bir bütçe kararının gerçekten ihtiyaç duyduğu sayı budur.
Mantık 1. bölümde anlatılanla aynıdır. Bir reklamın etkisi, reklamlı ve reklamsız iki dünya arasındaki farktır. Rastgele atama iki dünyayı aynı anda, yalnızca şans ve reklamla farklılaşan iki grupta yaratır.
Hangi deney tasarımları var?
| Tasarım | Rastgele atanan birim | Kontrol grubu nasıl oluşur | Ana gücü | Ana kör noktası |
|---|---|---|---|---|
| Niyet-tedavi (intent-to-treat) holdout | Kullanıcı | Hedef kitlenin rastgele bir payı reklama hiç uygun olmaz | Basit ve yansız | İki gruptakilerin çoğu reklamı zaten hiç görmeyecekti; sinyal seyrelir |
| PSA (plasebo) reklamları | Kullanıcı | Kontrol kullanıcıları ilgisiz bir reklam görür, örneğin bir bağış mesajı | Kimin reklamı göreceğini belirler | Reklamveren plasebo gösterimleri için ödeme yapar; teslimat algoritmaları iki reklama farklı davranabilir |
| Ghost ads | Kullanıcı | Platform, reklamı görecek olan kontrol kullanıcılarını hiçbir şey göstermeden kaydeder | Hassas ve ucuz | Platformun işbirliğini gerektirir; reklamveren uygulamayı denetleyemez |
| Bölgesel deney | Bölge | Rastgele seçilen bölgelerde reklam kapatılır ya da değiştirilir | Tüm kanallar ve çevrimdışı dahil toplam mağaza satışını ölçer | Çok sayıda benzer bölge gerekir; bölgeler gürültülüdür |
| Sentetik kontrol | Bölge (çoğunlukla az) | Müdahale görmemiş bölgelerin ağırlıklı bir birleşimi müdahale görmüş bölgeyi taklit eder | Yalnızca bir ya da birkaç bölgeye müdahale edilebildiğinde çalışır | Rastgele değildir; yalnızca ön dönem uyumu iyiyse geçerlidir |
| Bütçe düzeyi testi | Zaman ya da bölge | Bütçeler rastgele farklı düzeylere ayarlanır | Yalnızca açık/kapalıyı değil marjinal getiriyi ölçer | Birkaç dönem gerekir; etkiler dönemler arasında taşabilir |
Ghost ads neden önemli?
Çünkü 1. bölümde anlatılan ekonomi sorununu çözer. Sıradan bir holdout'ta kontrol grubu hedef kitledeki herkesi, hiçbir zaman ulaşılmayacak olan çok sayıda kişi dahil, kapsar. Bu kişilerin satın almaları bilgi eklemeden gürültü ekler.
Johnson, Lewis ve Nubbemeyer (2017), her kontrol kullanıcısı için reklam sisteminin reklamı göstereceği anı kaydetmeyi, sonra yalnızca bu "görecek olan" kullanıcıları gerçekten reklam görenlerle karşılaştırmayı önerdi. Uygulamaları günde 100 milyondan fazla öngörülen hayalet reklamı kaydetti. Niyet-tedavi ve PSA tasarımlarıyla karşılaştırıldığında artışı aynı hassasiyetle, en az on kat daha düşük maliyetle ölçtü. Görüntülü yeniden hedeflemeye uygulamalarında reklamlar site ziyaretlerini %17,2, satın almaları %10,5 artırdı. [Deney]
Buradan iki ders çıkar. Birincisi, yeniden hedefleme işe yarayabilir: bu, deneyle ölçülmüş pozitif bir etkidir. İkincisi, etki, reklamı gören ve görmeyen kullanıcıların saf karşılaştırmalarının ürettiği farklardan çok daha küçüktür; örneğin 4. bölümdeki Facebook çalışmasındaki %217'lik artıştan. Aradaki fark, orada anlatılan seçilimdir.
Bölgesel deney ne zaman kullanılmalı?
İzlenen dönüşümleri değil toplam satışı ölçmek istediğinizde ya da platform kullanıcı düzeyinde test yapamadığında. Bölgesel deney bazı bölgelerde reklamı değiştirir ve oradaki toplam satışları dokunulmamış bölgelerle karşılaştırır. Her kaynaktan gelen mağaza satışını ölçtüğü için izlemenin kaçırdığı etkileri yakalar: bir video görüp sonra arama yapan, çevrimdışı alan ya da başka bir cihaz kullanan alıcılar.
Çözülmüş bir örnek, bölgesel testlerin hem gücünü hem tuzağını gösteriyor.
Bir mağaza 8 teslimat bölgesinin yazı-turayla seçilen 4'ünde Instagram'ı 14 gün durduruyor. Durdurmadan önceki 14 günde iki grup da günde ortalama 50 sipariş alıyordu. Durdurma sırasında durdurulan bölgeler ortalama 46, aktif bölgeler 51 sipariş aldı.
- Durdurulan bölgelerdeki değişim: 46 − 50 = −4
- Aktif bölgelerdeki değişim: 51 − 50 = +1
- Durdurulan yarıdaki tahmini etki: −4 − (+1) = günde −5 sipariş
- Tüm mağaza için etki (8 bölge): yaklaşık günde −10 sipariş
Sipariş başına 20 € kârla merkezi tahmin Instagram'ın değerini günde yaklaşık 200 € gösteriyor; günlük harcama 400 €. Son tıklama raporları ona günde 5 sipariş yazıyor, testin tahmininin yarısı.
Açıklayıcı örnek. Mağaza siparişlerinin yaklaşık %10'u kadar bir etki, yayımlanmış deneylerdeki satın alma artışlarına yakındır: 663 deneyde alt huni sonuçları için medyan %5 (4. bölüm), yeniden hedeflemede %10,5 (yukarıda). 8. bölümdeki testin 3. vakası aynı tasarımı çok daha büyük bir etkiyle kullanıyor.
İki adımda hata yapmak kolaydır. Aktif bölgeler de +1 hareket etti; bu yüzden etki, yalnızca durdurulan bölgelerdeki değişim değil, iki değişimin farkıdır. Ve test mağazanın yarısını kapsadı; bu yüzden sonuç tüm mağazanın harcamasıyla karşılaştırılmadan önce tüm mağazaya ölçeklenmelidir. 8. bölüm, yapay zekâ analistlerinin cevaplarının çoğunda ikinci adımı atladığını gösteriyor.
Tahminin bir aralığa da ihtiyacı var. Siparişler birbirinden bağımsız geliyorsa, ortalaması 50 olan günlük sayı yaklaşık √50 ≈ 7 sipariş oynar; bu yüzden böyle iki grup arasındaki günlük fark yaklaşık √(50 + 50) = 10 oynar. Etki, durdurmadan önceki 14 günün ortalama farkını durdurmanın 14 gününün ortalama farkıyla karşılaştırır:
- Her 14 günlük ortalama farkın standart hatası: 10 ÷ √14 ≈ 2,7
- Etkinin standart hatası: √2 × 2,7 ≈ 3,8
- Durdurulan yarıda %95 aralık: −5 ± 1,96 × 3,8 → günde −12,4 ile +2,4 sipariş
- Tüm mağaza: günde −24,8 ile +4,8 sipariş; yani Instagram'ın değeri günde yaklaşık −96 € ile 496 € arasında
Aralık sıfır etkiden 400 €'luk harcamanın biraz üstüne uzanıyor. On dört gün son tıklamanın Instagram'ı eksik saydığını gösteriyor, ama Instagram'ın kendini amorti edip etmediğini gösteremiyor. Durdurmadan önce 6 hafta ve durdurma sırasında 6 hafta olsaydı, merkezi tahmin aynı kaldığında tüm mağaza aralığı günde yaklaşık 30–370 €'ya daralırdı; iki ucu da harcamanın altında. Bu aralık bile iyimser: günlerin bağımsız olduğunu ve tek gürültünün siparişlerin rastgele gelişi olduğunu varsayıyor; oysa gerçek bölgeler hava, teslimat ve yerel olaylar bakımından da farklılaşır. Test bittikten sonra gelen etkiler kaçırılır (6. bölüm). Formüller Ek F'de.
Meta'nın açık kaynak GeoLift paketi bu tasarım için yapıldı; Brodersen ve arkadaşlarının CausalImpact paketi de zaman serisi versiyonlarını destekliyor.


Bir deneyi güvenilir kılan nedir?
Rastgele atama seçilim yanlılığını kaldırır ama her hatayı kaldırmaz. Çevrimiçi deneyler literatürü (Kohavi, Tang ve Xu, 2020) kısa bir kontrol listesi öneriyor; liste reklam testlerine doğrudan uygulanır.
- Metriğe ve süreye başlamadan önce karar verin. Sonuç iyi göründüğünde durmak yanlış pozitifleri şişirir.
- Bölünmeyi kontrol edin. Gruplar tasarımın öngördüğü büyüklükte değilse atamada bir şey bozuktur ve sonuca güvenilmemelidir.
- Toplam sonuçları ölçün. 2. bölümdeki sorunları miras alan platform atfı dönüşümleri değil, mağaza cirosunu ya da siparişleri kullanın.
- Gecikmeye pay bırakın. Bazı etkiler temastan haftalar sonra gelir. Çok erken biten bir test onları olduğundan küçük gösterir.
- Kimin rastgele atadığını bilin. Bir platformun artış (lift) testi bir deneydir, ama reklam gören grubu platformun teslimat algoritması seçer; bu yüzden iki reklam arasındaki karşılaştırmalar ayrışan teslimat sorununa tabidir (Braun ve Schwartz, 2025).
- Yalnızca tahmini değil aralığı raporlayın. 1. bölümdeki gürültü düzeylerinde dürüst bir sonuç çoğu zaman hem bir kaybı hem büyük bir kazancı kapsar.
Bir deney neyi söyleyemez?
[Bizim okumamız] Bir deney tek bir soruyu iyi cevaplar: bu kampanya, bu dönemde, bu kitle için neye yol açtı. Üç başka soruyu cevaplamaz.
- Başka bütçeler. Bir kanalı kapatmak, kanalın mevcut harcamadaki değerini söyler. Bir sonraki 1.000 €'nun ne getireceğini söylemez.
- Başka zamanlar. Etkiler mevsimle, kreatifle ve rekabetle değişir. Geçen bahardan bir deney, geçen bahar hakkında kanıttır.
- Başka kanallar. Kanalları tek tek test etmek aralarındaki etkileşimleri kaçırır; 3. bölüm bunların büyük olabileceğini gösterdi.
Varian (2016), iş kararlarının tam olarak bu karşı-olgusal akıl yürütmeyi gerektirdiğini ve mümkün olduğunda deneylerin ona giden en doğrudan yol olduğunu genel olarak savunuyor. Pratik sorun şu: bir işletme her kanal için, her bütçe düzeyinde, her ay deney yapamaz.
Bu bölümün sınırı
Deneyler yereldir ve pahalıdır. Bir bütçe kararı tek bir kanal için açık/kapalı cevabından fazlasını gerektirir: harcama arttıkça getirinin nasıl değiştiğini, etkilerin ne kadar sürede geldiğini ve kanalların nasıl etkileştiğini bilmek gerekir. 6. bölüm bütçenin kanıtı nasıl izlemesi gerektiğini soruyor.
Kaynaklar
- Abadie, A. (2021). Using synthetic controls: Feasibility, data requirements, and methodological aspects. Journal of Economic Literature, 59(2), 391–425. doi:10.1257/jel.20191450
- Braun, M., & Schwartz, E. M. (2025). Where A/B testing goes wrong. Journal of Marketing, 89(2), 71–95. doi:10.1177/00222429241275886
- Brodersen, K. H., Gallusser, F., Koehler, J., Remy, N., & Scott, S. L. (2015). Inferring causal impact using Bayesian structural time-series models. Annals of Applied Statistics, 9(1), 247–274. doi:10.1214/14-AOAS788
- Johnson, G. A., Lewis, R. A., & Nubbemeyer, E. I. (2017). Ghost ads: Improving the economics of measuring online ad effectiveness. Journal of Marketing Research, 54(6), 867–884. doi:10.1509/jmr.15.0297
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press. doi:10.1017/9781108653985
- Lewis, R. A., & Rao, J. M. (2015). The unfavorable economics of measuring the returns to advertising. Quarterly Journal of Economics, 130(4), 1941–1973. doi:10.1093/qje/qjv023
- Meta. GeoLift: open-source geo experimentation. https://github.com/facebookincubator/GeoLift
- Varian, H. R. (2016). Causal inference in economics and marketing. Proceedings of the National Academy of Sciences, 113(27), 7310–7315. doi:10.1073/pnas.1510479113
 Edip Ali Avcıbaşı · Co-founder & CAOMeerkads ve Byte Digital'in kurucu ortağı ve CAO'su. 2020'den beri ajans operasyonunu yönetiyor; dijital pazarlama, SEO ve pazaryeri tarafında çalıştı.